San Antonio 2012 : Quand l'IA a commencé à ficher nos enfants
En 2012, des collégiens de San Antonio ont inauguré une nouvelle ère éducative. Leurs plateformes d'apprentissage personnalisées ont introduit une révolution silencieuse, mais aussi la collecte massive de leurs données, soulevant d'importantes questions.
L’IA à l’école : à qui appartiennent les données de votre enfant ?
5 septembre 2012. Des collégiens de San Antonio, au Texas, ont commencé à utiliser de nouvelles plateformes d’apprentissage personnalisées. Ce n’était pas seulement un nouvel outil ; c’était une révolution silencieuse. Ces plateformes promettaient de s’adapter au rythme de chaque enfant. Elles ont également commencé à collecter une quantité considérable de données sur les élèves.
Ce changement a transformé définitivement la technologie éducative. Les écoles ont troqué les manuels statiques contre des outils numériques dynamiques et réactifs. Mais ce changement a soulevé d’importantes questions concernant la vie privée des élèves. Le passage des simples carnets de notes numériques aux tuteurs IA sophistiqués n’a fait qu’accentuer ces préoccupations.
Comment les salles de classe sont devenues numériques
Pendant des décennies, les données des élèves sont restées sur papier. Les dossiers tels que les registres de présence, les notes et les sanctions disciplinaires étaient conservés dans des armoires verrouillées. Les enseignants connaissaient bien leurs élèves. Ils comprenaient les besoins d’apprentissage de chaque enfant grâce à l’interaction directe.
À la fin des années 1990, des outils numériques de base sont apparus. Les écoles ont commencé à utiliser des logiciels pour les tâches administratives. Ces premiers systèmes se contentaient principalement de numériser d’anciens dossiers. Ils ont rendu les choses plus efficaces. Mais ils n’ont pas vraiment changé la façon dont les écoles collectaient les données.
Le début des années 2000 a vu l’arrivée des systèmes de gestion de l’apprentissage (LMS). Des plateformes comme Blackboard et Moodle sont devenues courantes. Ces plateformes ont facilité la soumission des devoirs et le suivi des notes. Elles stockaient plus d’informations en ligne. Mais elles se limitaient principalement à collecter des données de performance académique.
En 2006, Google a lancé Google Apps for Education. Cette suite comprenait Gmail, Docs et Agenda. Elle a rapidement été adoptée dans les écoles primaires et secondaires (K-12). Les districts ont plébiscité ces outils ; ils étaient bon marché et facilitaient la collaboration. Bientôt, un volume considérable de communications et de travaux scolaires des élèves résidait sur les serveurs de Google.
Ce changement a suscité de nouvelles discussions. Les écoles ont adopté de puissants outils numériques. Elles l’ont souvent fait sans comprendre pleinement les enjeux liés aux données. Les données des élèves étaient désormais transmises à des entreprises tierces. Ces entreprises avaient leurs propres modèles commerciaux et politiques de gestion des données.
Quand l’IA est arrivée à l’école
En 2012, l’apprentissage personnalisé était devenu un enjeu majeur. Des entreprises comme Knewton, basée à New York, ont ouvert la voie avec des plateformes d’apprentissage adaptatif. La technologie de Knewton utilisait des algorithmes. Elle analysait les données de performance des élèves. Ensuite, elle recommandait un contenu éducatif sur mesure.
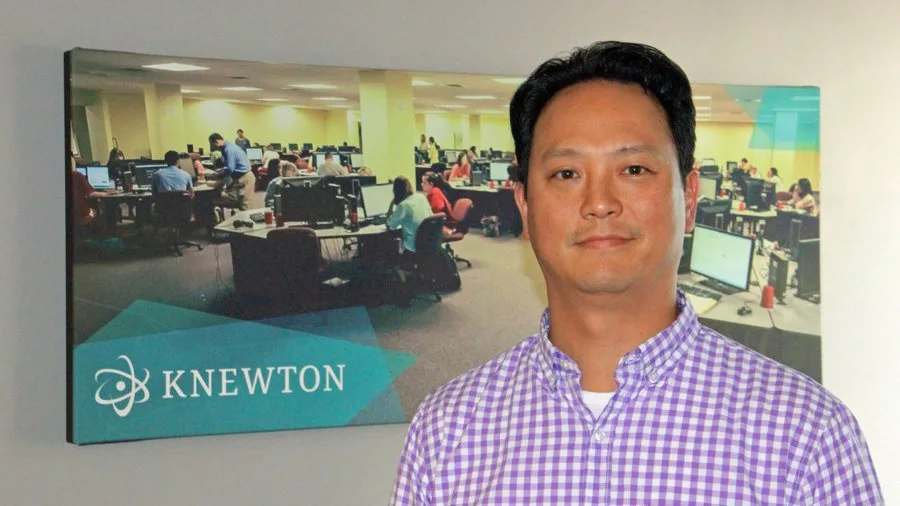
Fondée en 2008, Knewton était une entreprise pionnière dans l'apprentissage adaptatif, développant des plateformes qui utilisaient des algorithmes pour analyser les données des élèves et personnaliser le contenu éducatif. Son essor au début des années 2010 a marqué un changement significatif vers une éducation axée sur les données, suscitant les premiers débats sur la vie privée des élèves. (Source : bizjournals.com)
Knewton s’est associée à de grands éditeurs. Son PDG, Jose Ferreira, a partagé publiquement une vision ambitieuse. Il imaginait un avenir où chaque élève suivrait un parcours d’apprentissage unique. La science des données rendrait ce parcours aussi efficace que possible. L’entreprise affirmait que ses algorithmes pouvaient prédire la réussite des élèves.
Cette nouvelle vague d’outils d’IA collectait bien plus que de simples notes. Ils suivaient chaque clic, chaque pause et chaque réponse. Ils surveillaient le temps passé sur les questions. Ils enregistraient les modèles d’interaction. Ces données détaillées étaient censées affiner les algorithmes d’apprentissage. Elles construisaient également des profils numériques approfondis des élèves.
Des préoccupations ont commencé à surgir. En 2014, le Future of Privacy Forum (FPF) a publié un rapport. Il a souligné les pratiques opaques des ed-tech en matière de données. Amelia Vance du FPF a noté que de nombreux contrats scolaires étaient lacunaires. Ils ne définissaient pas clairement la propriété ou l’utilisation des données. Cela laissait les données des élèves exposées.
Le Student Privacy Pledge a été lancé en 2014. Plus de 200 entreprises ed-tech ont adhéré à cette initiative de l’industrie. Elles ont promis de ne pas vendre les données des élèves. Elles se sont également engagées à ne pas les utiliser pour la publicité ciblée. Cela a montré une prise de conscience croissante. Cela a également reflété la pression des défenseurs de la vie privée.
Mais l’engagement était volontaire. Il n’avait aucun mécanisme de contrôle. De nombreuses entreprises collectaient encore une quantité importante de données. Elles utilisaient ces données pour améliorer leurs produits. Cette pratique a souvent brouillé les pistes. Elle a soulevé des questions sur le véritable objectif de la collecte de données.
COVID-19 : une ruée vers l’or des données
En mars 2020, la COVID-19 a contraint les écoles du monde entier à l’apprentissage à distance. Cet événement a accéléré l’adoption des ed-tech. Des millions d’élèves sont passés aux plateformes en ligne du jour au lendemain. Zoom, Google Classroom et divers outils d’évaluation basés sur l’IA sont devenus essentiels.
Ce changement rapide a également exposé les élèves à de nouvelles méthodes de collecte de données. Les services de surveillance en ligne, comme Proctorio et Honorlock, ont connu un essor fulgurant. Ces outils utilisaient l’IA. Ils surveillaient les élèves pendant les examens. Ils utilisaient des webcams, des microphones et le partage d’écran pour détecter les comportements suspects.
Ces outils de surveillance collectaient des données biométriques. Ils analysaient les mouvements faciaux et le regard. Ils enregistraient les environnements audio. Les élèves ont fait état d’un stress important. Ils s’inquiétaient des fausses accusations de tricherie. Les défenseurs de la vie privée ont dénoncé cette surveillance invasive.
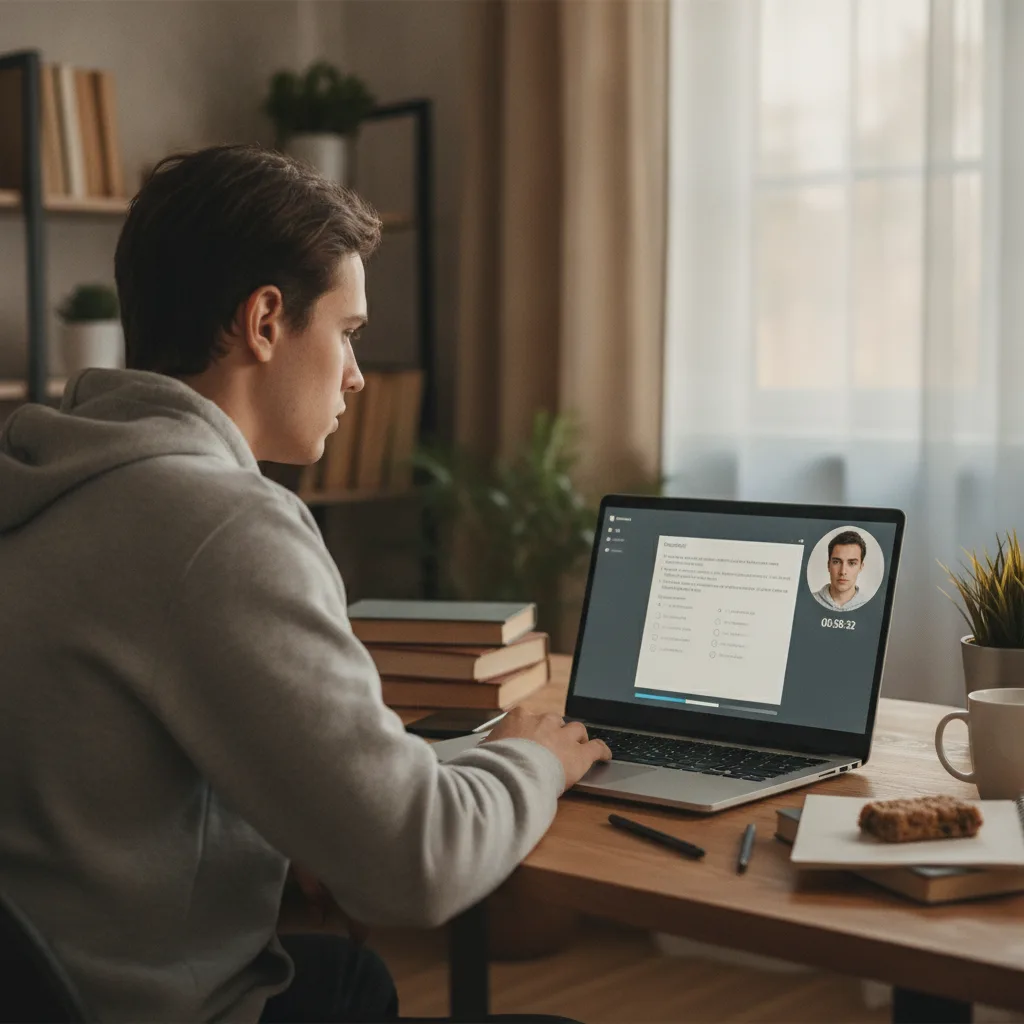
Pendant la pandémie de COVID-19, les logiciels de surveillance en ligne comme Proctorio et Honorlock ont connu une utilisation accrue, employant l'IA pour surveiller les élèves via des webcams, des microphones et le partage d'écran, soulevant des préoccupations importantes concernant la collecte de données biométriques et la vie privée des élèves. (Illustration générée par l'IA)
L’Electronic Frontier Foundation (EFF) s’est fortement opposée. Dans un livre blanc de 2020, Bill Fitzgerald de l’EFF a qualifié ces outils d’« intrusifs pour la vie privée ». Il a averti que des dossiers permanents de surveillance des élèves étaient créés. Ces dossiers pourraient suivre les élèves au-delà de leurs années d’école primaire et secondaire (K-12).
Les outils d’apprentissage socio-émotionnel (SEL) ont également suscité des inquiétudes. Certaines plateformes d’IA prétendaient détecter les émotions des élèves. Elles utilisaient la reconnaissance faciale ou l’analyse vocale. Ces outils visaient à identifier les élèves ayant besoin de soutien. Les critiques ont qualifié cela de très intrusif. Ils ont remis en question la précision et l’éthique d’une telle surveillance.
L’essor fulgurant de l’apprentissage numérique a entraîné un afflux massif de données sur les élèves. Les écoles manquaient souvent de ressources. Elles avaient du mal à évaluer les risques de confidentialité de chaque nouvelle plateforme. Cela a créé des conditions propices aux violations de données et aux abus.
Règles et nouveaux problèmes
Les législateurs ont réagi à l’augmentation de la collecte de données. En 2013, la Californie a adopté le Student Online Personal Information Protection Act (SOPIPA). Il a empêché les entreprises ed-tech de cibler les élèves avec des publicités. Il a également interdit la création de profils d’élèves à des fins non éducatives. Ce fut une loi d’État historique.
Au niveau national, le Family Educational Rights and Privacy Act (FERPA) est resté la principale loi fédérale. Le FERPA protège les dossiers scolaires des élèves. Mais il a été rédigé en 1974. Il est antérieur à l’internet et à l’IA. Son application aux ed-tech modernes a fait l’objet d’un grand débat.
En 2021, la Federal Trade Commission (FTC) a averti les entreprises ed-tech. Elle leur a rappelé leurs obligations en vertu de la COPPA. Le Children’s Online Privacy Protection Act (COPPA) exige le consentement parental pour collecter des données auprès d’enfants de moins de 13 ans. La FTC a souligné que les entreprises ne peuvent pas forcer les parents à renoncer à leurs droits à la vie privée.
L’IA générative est arrivée en 2022, apportant de nouveaux dilemmes en matière de vie privée. Des outils comme ChatGPT sont entrés dans les salles de classe. Les élèves les ont utilisés pour l’écriture, la recherche et la résolution de problèmes. Ces modèles d’IA apprennent à partir des contributions des utilisateurs. Cela signifie que les requêtes des élèves et leurs travaux originaux font partie des données d’entraînement.
OpenAI, le développeur de ChatGPT, a déclaré utiliser le contenu des utilisateurs. Ce contenu aide à améliorer ses modèles. Mais il propose également des versions d’entreprise. Ces versions promettent de ne pas utiliser les données des clients pour l’entraînement. Cette différence est vitale pour les écoles. Elles doivent comprendre comment les données de leurs élèves sont traitées.
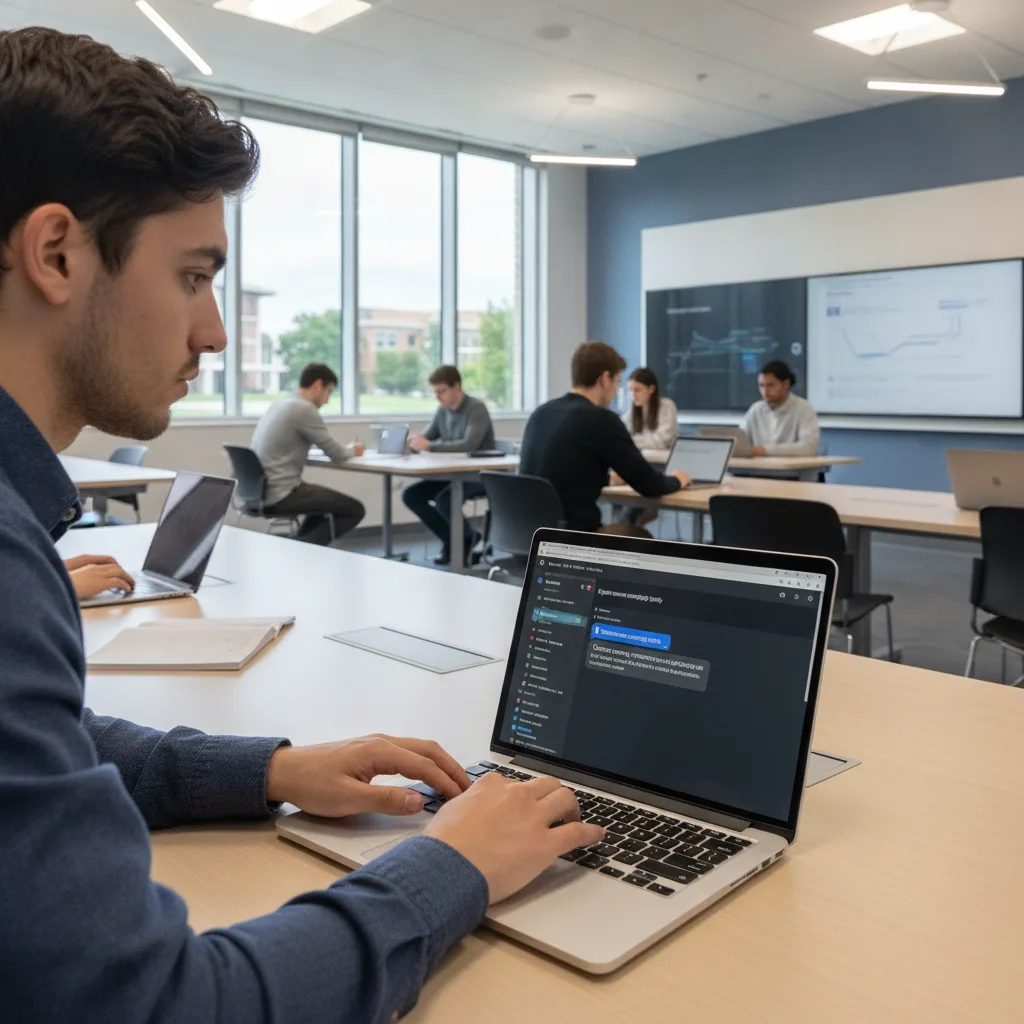
ChatGPT, développé par OpenAI, est rapidement entré dans les salles de classe en 2022, suscitant de nouveaux débats sur la confidentialité des données des élèves, car les contributions des utilisateurs font partie de ses données d'entraînement. (Illustration générée par l'IA)
Le Dr Neil Selwyn, professeur d’éducation à l’Université Monash, a souligné ce problème. Il a noté que la vie privée des élèves est souvent négligée. Les écoles se concentrent sur les avantages pédagogiques de l’IA. Elles ignorent souvent son empreinte numérique. Cela crée un risque majeur.
Protéger les enfants dans un monde numérique
La protection des données des élèves est cruciale à l’ère de l’IA. L’IA dans l’éducation offre un enseignement personnalisé et un apprentissage adaptatif. Mais elle exige également une vigilance accrue en matière de confidentialité des données. Les écoles, les parents et les décideurs politiques doivent travailler ensemble. Ils doivent fixer des limites claires.
Une étape clé est une vérification rigoureuse des fournisseurs. Les écoles doivent examiner minutieusement les contrats ed-tech. Elles doivent comprendre quelles données sont collectées. Elles doivent savoir comment elles sont stockées et utilisées. Elles devraient privilégier les entreprises qui minimisent la collecte de données.
L’éducation des élèves et des parents est également vitale. Ils doivent comprendre leurs droits numériques. Ils devraient savoir comment leurs données sont utilisées. Une communication claire de la part des écoles peut renforcer la confiance. Cela aide également les individus à maîtriser leurs données.
Les décideurs politiques doivent mettre à jour les lois existantes. De nouvelles règles sont nécessaires. Ces lois doivent aborder les complexités de la collecte de données basée sur l’IA. Elles doivent garantir que les données des élèves ne sont utilisées qu’à des fins éducatives. Une application plus rigoureuse est essentielle.
L’objectif est d’utiliser le potentiel de l’IA sans compromettre la vie privée des élèves. La salle de classe numérique devrait favoriser l’apprentissage, et non devenir une zone de surveillance. Il ne s’agit pas seulement de protéger les données ; il s’agit de protéger l’enfance elle-même. Si nous échouons, les écoles risquent de devenir des usines à données, et non des lieux de découverte. La lutte pour la confidentialité numérique dans l’éducation ne fait que commencer.
Questions que vous pourriez avoir
Quel type de données d’élèves l’IA collecte-t-elle ? Les outils d’IA dans l’éducation peuvent collecter de nombreux types de données. Cela inclut les performances académiques, les registres de présence, les modèles de comportement et les données d’interaction (clics, temps passé). Certains outils recueillent également des données biométriques comme les expressions faciales et les mouvements oculaires.
À qui appartiennent les données des élèves collectées par les outils d’IA ? La propriété des données est souvent complexe et dépend des contrats. Généralement, les écoles sont responsables des données des élèves. Mais les entreprises ed-tech qui traitent ces données conservent souvent le droit de les utiliser pour l’amélioration de leurs produits.
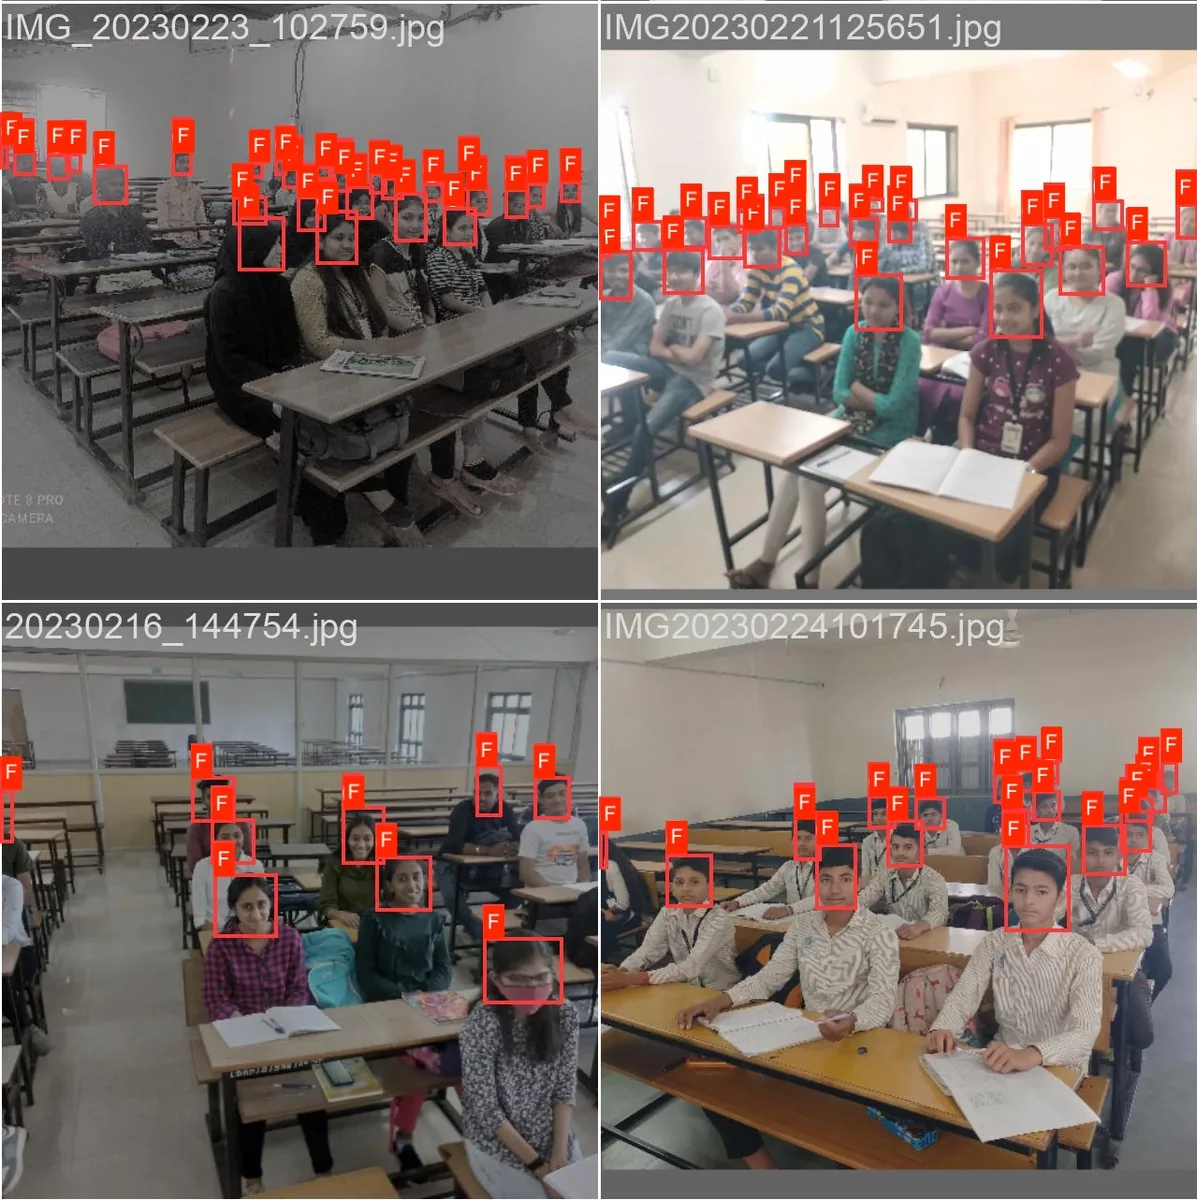
Les outils d'IA dans l'éducation collectent de plus en plus de données biométriques sensibles, telles que les expressions faciales et les mouvements oculaires des élèves, pour évaluer l'engagement ou la compréhension. Cette pratique soulève d'importantes préoccupations en matière de confidentialité, car ces données pourraient révéler des informations personnelles au-delà des performances académiques. (Source : arxiv.org)
Quelles lois protègent la confidentialité des données des élèves ? Aux États-Unis, le FERPA (Family Educational Rights and Privacy Act) et le COPPA (Children’s Online Privacy Protection Act) sont les principales lois fédérales. De nombreux États, comme la Californie avec le SOPIPA, ont également adopté leurs propres lois sur la confidentialité des données des élèves.
Que peuvent faire les parents pour protéger les données de leurs enfants ? Les parents peuvent interroger les écoles sur leurs politiques de confidentialité des données. Ils devraient se renseigner sur les outils ed-tech utilisés et examiner leurs politiques de confidentialité. Les parents peuvent également faire pression pour des protections de la vie privée plus strictes lors des réunions des conseils scolaires et auprès des législateurs.
Les réunions des conseils scolaires sont des forums publics cruciaux où les parents peuvent dialoguer directement avec les dirigeants de l'éducation locale pour plaider en faveur de politiques de confidentialité des données des élèves plus strictes et examiner l'utilisation des outils ed-tech. (Illustration générée par l'IA)
Vous pourriez aussi aimer:
👉 L’IA et les jeunes : les risques mondiaux des applications et réseaux
👉 La réalité virtuelle dans l’éducation : révolutionner l’apprentissage et les salles de classe
👉 Mai 2017: WannaCry, le rançongiciel qui a paralysé les hôpitaux britanniques