5 settembre 2012: A San Antonio l'AI in classe, al via la raccolta dei dati degli studenti
Nel 2012, le scuole di San Antonio hanno adottato strumenti digitali avanzati, promettendo un apprendimento su misura. Ma questa innovazione, guidata dall'AI, ha anche segnato l'inizio della raccolta massiva di dati sugli studenti, aprendo il dibattito sulla privacy.
L’IA nelle scuole: chi possiede i dati di tuo figlio?
5 settembre 2012. Gli studenti delle scuole medie di San Antonio, Texas, si sono collegati a nuove dashboard di apprendimento personalizzato. Questo non era solo un nuovo strumento; era una rivoluzione silenziosa. Queste piattaforme promettevano di adattarsi al ritmo di ogni bambino. Hanno anche iniziato a raccogliere un’enorme quantità di dati sugli studenti.
Questo cambiamento ha modificato per sempre la tecnologia educativa. Le scuole hanno sostituito i libri di testo statici con strumenti digitali dinamici e reattivi. Ma questo cambiamento ha sollevato grandi interrogativi sulla privacy degli studenti. Il passaggio dai semplici registri di classe digitali ai sofisticati tutor basati sull’IA non ha fatto che acuire queste preoccupazioni.
Come le aule sono diventate digitali
Per decenni, i dati degli studenti sono rimasti su carta. Registri come presenze, voti e note disciplinari erano conservati in armadietti chiusi a chiave. Gli insegnanti conoscevano bene i loro studenti. Comprendevano le esigenze di apprendimento di ogni bambino attraverso l’interazione diretta.
Verso la fine degli anni ‘90, sono arrivati gli strumenti digitali di base. Le scuole hanno iniziato a utilizzare software per compiti amministrativi. Questi primi sistemi si limitavano principalmente a digitalizzare vecchi registri. Rendenvano le cose più efficienti. Ma non hanno realmente cambiato il modo in cui le scuole raccoglievano i dati.
I primi anni 2000 hanno visto l’introduzione dei Sistemi di Gestione dell’Apprendimento (LMS). Piattaforme come Blackboard e Moodle sono diventate comuni. Queste piattaforme facilitavano la consegna dei compiti e il monitoraggio dei voti. Memorizzavano più informazioni online. Ma raccoglievano principalmente dati sulle prestazioni accademiche.
Nel 2006, Google ha introdotto Google Apps for Education. Questa suite includeva Gmail, Docs e Calendar. Si è rapidamente diffusa nelle scuole primarie e secondarie. I distretti scolastici apprezzarono molto questi strumenti; erano economici e facilitavano la collaborazione. Presto, un’enorme quantità di comunicazioni e di elaborati degli studenti risiedeva sui server di Google.
Questo cambiamento ha avviato nuove discussioni. Le scuole hanno adottato potenti strumenti digitali. Spesso lo facevano senza comprendere appieno le implicazioni sui dati. I dati degli studenti venivano ora trasferiti a società terze. Queste aziende avevano i propri modelli di business e politiche sui dati.
Quando l’IA è arrivata a scuola
Entro il 2012, l’apprendimento personalizzato aveva assunto grande rilevanza. Aziende come Knewton, con sede a New York, aprivano la strada con piattaforme di apprendimento adattivo. La tecnologia di Knewton utilizzava algoritmi. Analizzava i dati sulle prestazioni degli studenti. Poi raccomandava contenuti educativi personalizzati.
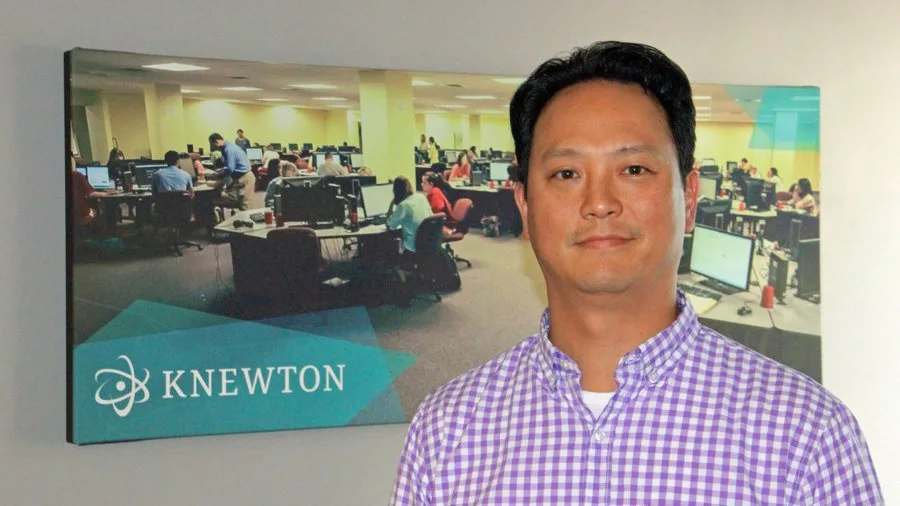
Fondata nel 2008, Knewton è stata un'azienda pionieristica nell'apprendimento adattivo, sviluppando piattaforme che utilizzavano algoritmi per analizzare i dati degli studenti e personalizzare i contenuti educativi. La sua ascesa nei primi anni 2010 ha segnato un cambiamento significativo verso un'istruzione basata sui dati, scatenando i primi dibattiti sulla privacy degli studenti. (Fonte: bizjournals.com)
Knewton ha collaborato con importanti editori. Il suo CEO, Jose Ferreira, ha condiviso pubblicamente una visione ambiziosa. Immaginava un futuro in cui ogni studente avrebbe avuto un percorso di apprendimento unico. La scienza dei dati avrebbe reso questo percorso il più efficace possibile. L’azienda affermava che i suoi algoritmi potevano prevedere il successo degli studenti.
Questa nuova ondata di strumenti AI raccoglieva più dei semplici voti. Monitoravano ogni clic, pausa e risposta. Controllavano il tempo trascorso sulle domande. Registravano i modelli di interazione. Questi dati dettagliati avrebbero dovuto perfezionare gli algoritmi di apprendimento. Costruivano anche profondi profili digitali degli studenti.
Iniziarono a sorgere preoccupazioni. Nel 2014, il Future of Privacy Forum (FPF) pubblicò un rapporto. Evidenziava le pratiche opache sui dati dell’ed-tech. Amelia Vance dell’FPF notò che molti contratti scolastici erano deboli. Non definivano chiaramente la proprietà o l’uso dei dati. Questo lasciava i dati degli studenti esposti.
Lo Student Privacy Pledge fu lanciato nel 2014. Questa iniziativa del settore vide oltre 200 aziende ed-tech aderire. Promisero di non vendere i dati degli studenti. Si impegnarono anche a non usarli per pubblicità mirata. Questo dimostrò una crescente consapevolezza. Rifletteva anche la pressione degli attivisti per la privacy.
Ma l’impegno era volontario. Non aveva alcun meccanismo di applicazione. Molte aziende raccoglievano ancora molti dati. Usavano questi dati per migliorare i prodotti. Questa pratica spesso sfumava i confini. Sollevava interrogativi sul vero scopo della raccolta dati.
COVID-19: una corsa all’oro dei dati
Nel marzo 2020, il COVID-19 ha costretto le scuole di tutto il mondo all’apprendimento a distanza. Questo evento ha accelerato l’adozione dell’ed-tech. Milioni di studenti si sono spostati su piattaforme online da un giorno all’altro. Zoom, Google Classroom e vari strumenti di valutazione basati sull’IA sono diventati essenziali.
Questo rapido cambiamento ha anche esposto gli studenti a nuovi metodi di raccolta dati. I servizi di proctoring online, come Proctorio e Honorlock, hanno visto un’impennata nell’uso. Questi strumenti utilizzavano l’IA. Monitoravano gli studenti durante gli esami. Utilizzavano webcam, microfoni e condivisione dello schermo per rilevare comportamenti sospetti.
Questi strumenti di proctoring raccoglievano dati biometrici. Analizzavano i movimenti facciali e lo sguardo. Registravano gli ambienti audio. Gli studenti hanno riferito di provare un forte stress. Si preoccupavano di false accuse di imbroglio. Gli attivisti per la privacy hanno denunciato a gran voce questa sorveglianza invasiva.
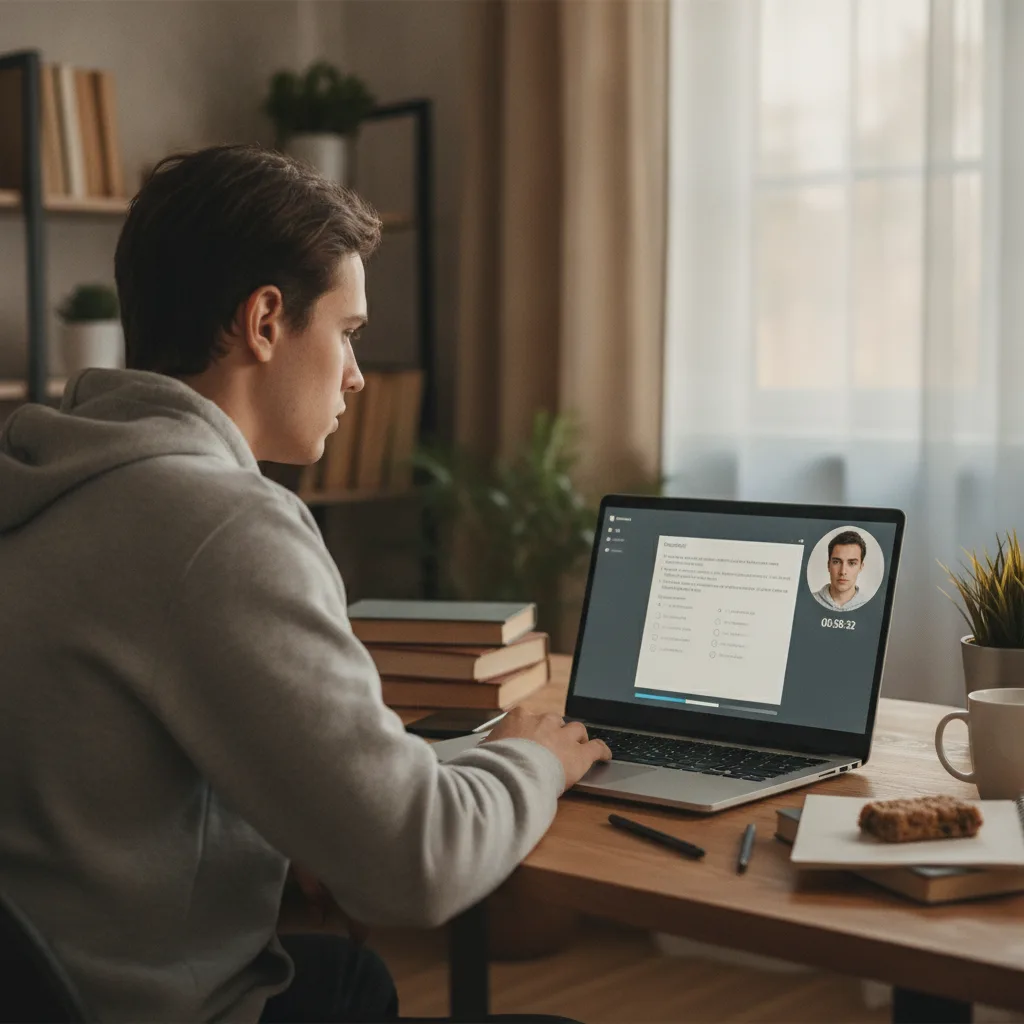
Durante la pandemia di COVID-19, i software di proctoring online come Proctorio e Honorlock hanno visto un'impennata nell'uso, impiegando l'IA per monitorare gli studenti tramite webcam, microfoni e condivisione dello schermo, sollevando significative preoccupazioni sulla raccolta di dati biometrici e sulla privacy degli studenti. (Illustrazione generata dall'IA)
L’Electronic Frontier Foundation (EFF) si è fortemente opposta. In un white paper del 2020, Bill Fitzgerald dell’EFF ha definito questi strumenti “invasivi della privacy”. Ha avvertito che venivano creati registri permanenti di sorveglianza degli studenti. Questi registri avrebbero potuto seguire gli studenti oltre i loro anni di scuola primaria e secondaria.
Anche gli strumenti di apprendimento socio-emotivo (SEL) hanno destato preoccupazione. Alcune piattaforme basate sull’IA affermavano di rilevare le emozioni degli studenti. Utilizzavano il riconoscimento facciale o l’analisi vocale. Questi strumenti miravano a trovare studenti che necessitavano di supporto. I critici hanno definito questo approccio altamente intrusivo. Hanno messo in discussione l’accuratezza e l’etica di tale monitoraggio.
L’enorme salto nell’apprendimento digitale ha comportato un flusso massiccio di dati degli studenti. Le scuole spesso mancavano di risorse. Faticavano a vagliare ogni nuova piattaforma per i rischi per la privacy. Questo ha creato le condizioni ideali per violazioni dei dati e usi impropri.
Regole e nuovi problemi
I legislatori hanno risposto all’impennata nella raccolta dati. Nel 2013, la California ha approvato lo Student Online Personal Information Protection Act (SOPIPA). Impediva alle aziende ed-tech di indirizzare pubblicità agli studenti. Vietava anche la creazione di profili studenti per usi non educativi. Questa è stata una legge statale storica.
A livello nazionale, il Family Educational Rights and Privacy Act (FERPA) è rimasta la principale legge federale. Il FERPA protegge i registri educativi degli studenti. Ma è stata scritta nel 1974. È stata concepita prima di internet e dell’IA. Applicarla all’ed-tech moderna è stato oggetto di un grande dibattito.
Nel 2021, la Federal Trade Commission (FTC) ha avvertito le aziende ed-tech. Ha ricordato loro i loro obblighi COPPA. Il Children’s Online Privacy Protection Act (COPPA) richiede il consenso dei genitori per raccogliere dati da bambini sotto i 13 anni. La FTC ha sottolineato che le aziende non possono costringere i genitori a rinunciare ai diritti sulla privacy.
L’IA generativa è arrivata nel 2022, portando nuovi dilemmi sulla privacy. Strumenti come ChatGPT sono entrati nelle aule. Gli studenti li hanno usati per scrittura, ricerca e risoluzione di problemi. Questi modelli di IA imparano dagli input degli utenti. Ciò significa che le query degli studenti e i lavori originali diventano parte dei dati di addestramento.
OpenAI, lo sviluppatore di ChatGPT, ha affermato di utilizzare i contenuti degli utenti. Questo contenuto aiuta a migliorare i suoi modelli. Ma offre anche versioni aziendali. Queste versioni promettono di non addestrarsi sui dati dei clienti. Questa differenza è vitale per le scuole. Devono comprendere come vengono gestiti i dati dei loro studenti.
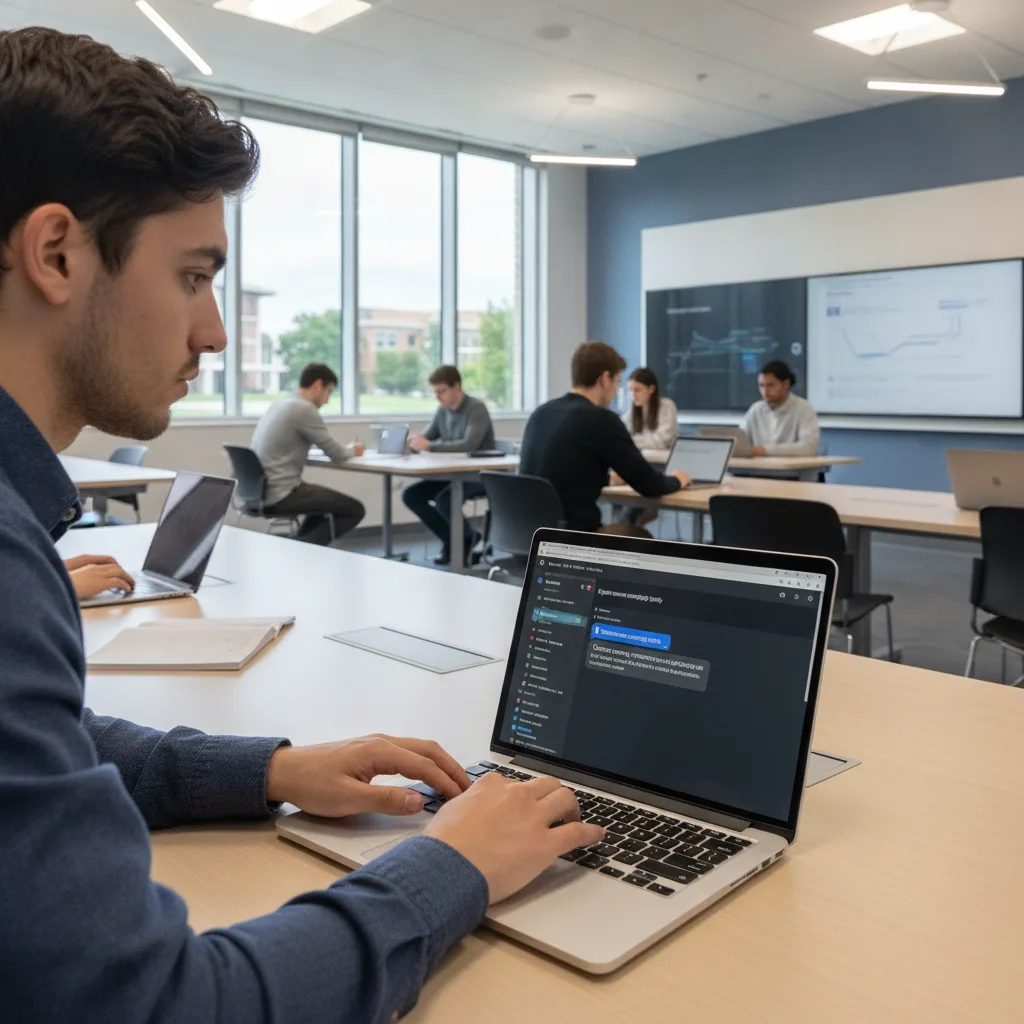
ChatGPT, sviluppato da OpenAI, è entrato rapidamente nelle aule nel 2022, scatenando nuovi dibattiti sulla privacy dei dati degli studenti poiché gli input degli utenti diventano parte dei suoi dati di addestramento. (Illustrazione generata dall'IA)
Il Dott. Neil Selwyn, professore di educazione alla Monash University, ha evidenziato questo problema. Ha notato che la privacy degli studenti viene spesso trascurata. Le scuole si concentrano sui benefici didattici dell’IA. Spesso ignorano l’impatto che ha sulla raccolta dati. Questo crea un grande rischio.
Proteggere i bambini in un mondo digitale
Proteggere i dati degli studenti è cruciale nell’era dell’IA. L’IA nell’educazione offre istruzione personalizzata e apprendimento adattivo. Ma richiede anche una rigorosa attenzione alla privacy dei dati. Scuole, genitori e legislatori devono lavorare insieme. Devono stabilire confini chiari.
Un passo fondamentale è una rigorosa verifica dei fornitori. Le scuole devono esaminare attentamente i contratti ed-tech. Devono comprendere quali dati vengono raccolti. Devono sapere come vengono archiviati e utilizzati. Dovrebbero dare priorità alle aziende che minimizzano la raccolta dati.
Educare studenti e genitori è anche vitale. Devono comprendere i loro diritti digitali. Dovrebbero sapere come vengono utilizzati i loro dati. Una comunicazione chiara da parte delle scuole può costruire fiducia. Aiuta anche gli individui a prendere il controllo.
I legislatori devono aggiornare le leggi esistenti. Sono necessarie nuove regole. Queste leggi devono affrontare le complessità della raccolta dati guidata dall’IA. Devono garantire che i dati degli studenti siano utilizzati solo per scopi educativi. Un’applicazione più rigorosa è essenziale.
L’obiettivo è utilizzare il potenziale dell’IA senza compromettere la privacy degli studenti. L’aula digitale dovrebbe favorire l’apprendimento, non diventare una zona di sorveglianza. Non si tratta solo di proteggere i dati; si tratta di proteggere l’infanzia stessa. Se falliamo, le scuole rischiano di diventare fabbriche di dati, non luoghi di scoperta. La lotta per la privacy digitale nell’educazione è appena iniziata.
Domande che potresti avere
Che tipo di dati degli studenti raccoglie l’IA? Gli strumenti di IA nell’educazione possono raccogliere molti tipi di dati. Ciò include prestazioni accademiche, presenze, modelli di comportamento e dati di interazione (clic, tempo trascorso). Alcuni strumenti raccolgono anche dati biometrici come espressioni facciali e movimenti oculari.
Chi possiede i dati degli studenti raccolti dagli strumenti di IA? La proprietà dei dati è spesso complessa e dipende dai contratti. Generalmente, le scuole sono responsabili dei dati degli studenti. Ma le aziende ed-tech che elaborano questi dati spesso mantengono i diritti di utilizzarli per il miglioramento del prodotto.
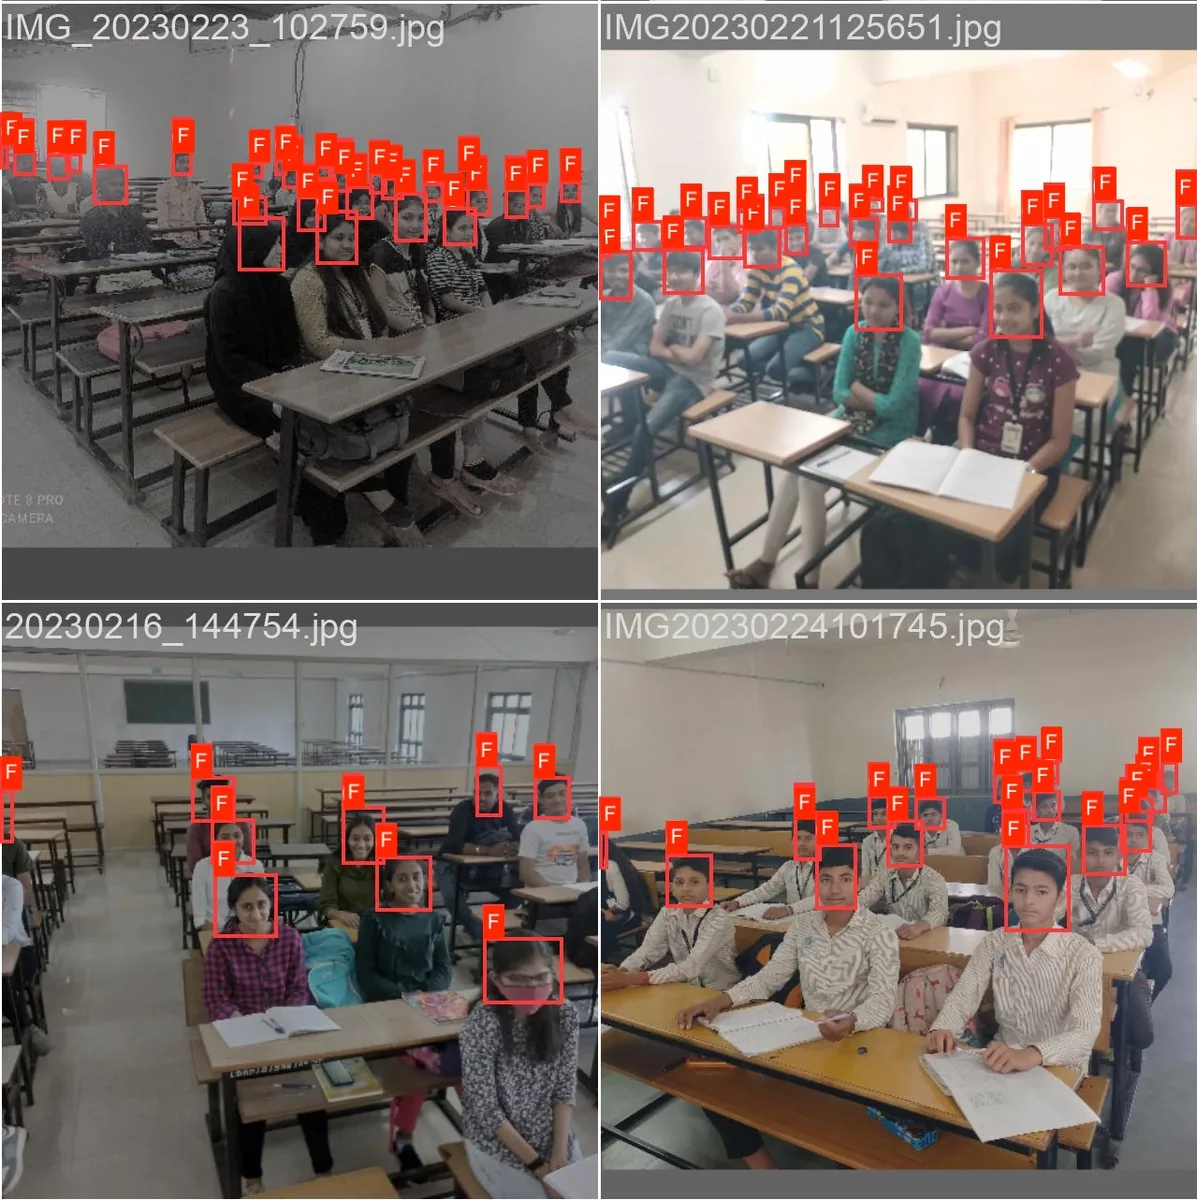
Gli strumenti di IA nell'istruzione stanno raccogliendo sempre più dati biometrici sensibili, come le espressioni facciali e i movimenti oculari degli studenti, per valutare il coinvolgimento o la comprensione. Questa pratica solleva significative preoccupazioni sulla privacy, poiché questi dati potrebbero rivelare informazioni personali al di là delle prestazioni accademiche. (Fonte: arxiv.org)
Quali leggi proteggono la privacy dei dati degli studenti? Negli Stati Uniti, il FERPA (Family Educational Rights and Privacy Act) e il COPPA (Children’s Online Privacy Protection Act) sono leggi federali chiave. Molti stati, come la California con SOPIPA, hanno anche approvato le proprie leggi sulla privacy degli studenti.
Cosa possono fare i genitori per proteggere i dati dei loro figli? I genitori possono chiedere alle scuole informazioni sulle loro politiche di privacy dei dati. Dovrebbero chiedere informazioni sugli strumenti ed-tech utilizzati e rivedere le loro politiche sulla privacy. I genitori possono anche sollecitare protezioni della privacy più solide nelle riunioni del consiglio scolastico e con i legislatori.
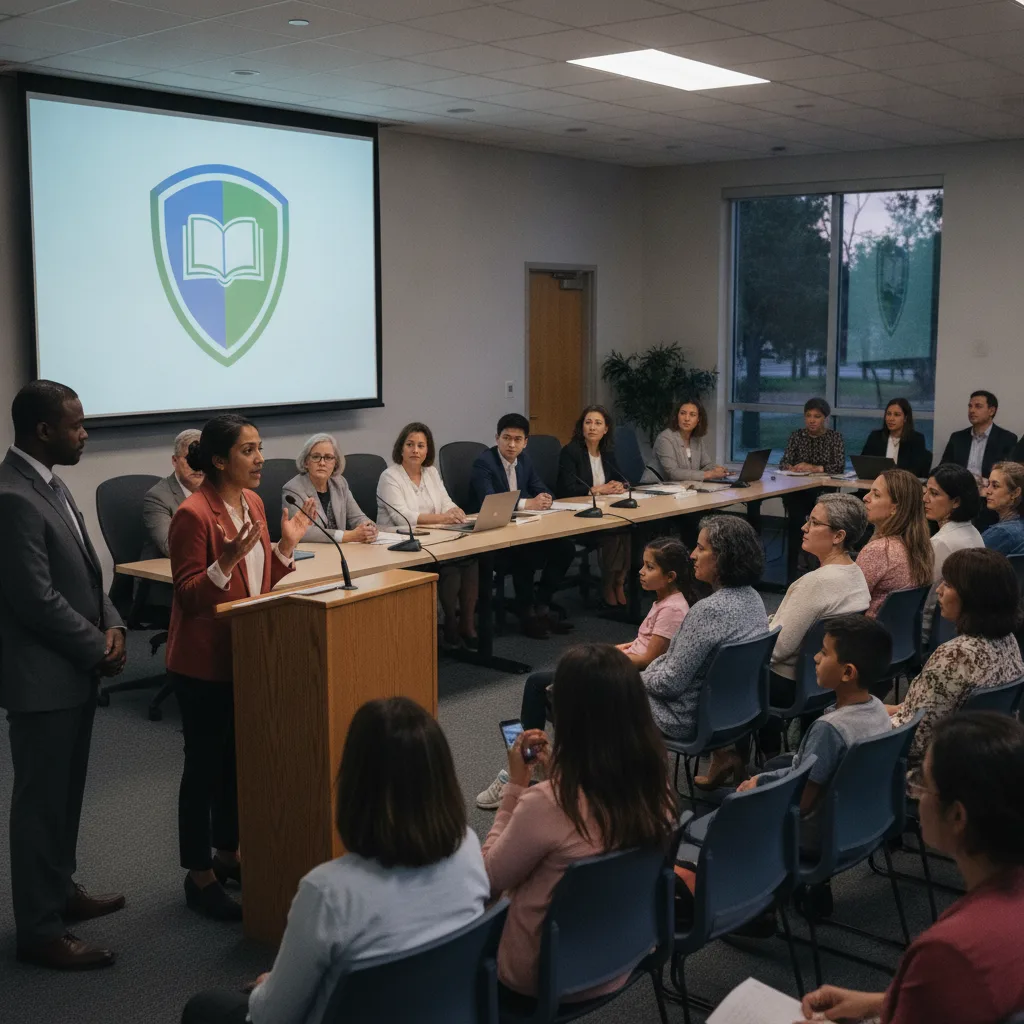
Le riunioni del consiglio scolastico fungono da forum pubblici cruciali in cui i genitori possono interagire direttamente con i leader dell'istruzione locale per sostenere politiche più solide sulla privacy dei dati degli studenti e rivedere l'uso degli strumenti ed-tech. (Illustrazione generata dall'IA)
Potrebbe interessarti anche:
👉 L’IA è già qui: per i giovani, oltre le promesse, i rischi concreti di app e social
👉 La VR nell’educazione: Rivoluzionare l’apprendimento e le aule
👉 12 maggio 2017: WannaCry, il cyberattacco che mise in ginocchio il NHS